
Hostinger VPS 上 AI Router 额度搭配 OpenClaw 使用教程
Hostinger AI Router 额度让你可以直接在 OpenClaw 内使用大语言模型,无需管理单独的 API 密钥或外部集成。当 OpenClaw 连接到 Hostinger AI Router 后,所有模型使用量都将通过你的 AI 额度计费,而不是通过单独的服务商账户。
这大大降低了上手门槛,尤其是当你想要尝试不同的 AI 模型,或者不想配置多个 API 密钥时。
随 OpenClaw 购买 AI 额度
通过 Hostinger Docker 目录部署 OpenClaw 时,你可以在购物车中直接添加 AI 额度。
如果你在结账时选择了 AI 额度,集成会自动完成。容器部署完成后,OpenClaw 将立即连接到 Hostinger AI Router,无需手动复制、粘贴或管理 API 密钥。
如果购买时未添加 AI 额度,OpenClaw 仍然可以正常工作,但你需要手动配置自己的 AI 服务商凭据。
自动集成 AI Router
当你的 OpenClaw 订单中包含 AI 额度时:
- OpenClaw 会自动通过 Hostinger AI Router 完成身份验证
- 无需任何 API 密钥或环境变量
- 使用量将从你的 AI 额度余额中扣除
- 你可以直接在 OpenClaw 界面中切换支持的 AI 模型
这种设置对于注重安全性和简易性的生产环境尤其有用。
如何将 AI Router 额度连接到已有的 OpenClaw 实例
如果你已购买 AI 额度,并希望将其用于之前部署的另一个 OpenClaw 实例,可以通过添加 API 密钥手动连接。
- 在 Docker Manager 中点击 Copy key 复制你的 AI Router API 密钥,或者按照 Hostinger 控制面板 → AI Router → API key 路径复制
- 点击 Manage 打开 OpenClaw Docker 配置
- 打开 Environment 标签页
- 添加一个新的环境变量,内容如下:NEXOS_API_KEY
:[PASTE_YOUR_AI_ROUTER_API_KEY_HERE] - 点击 Deploy 重新部署你的 OpenClaw 容器
- 容器重启后,打开你的 OpenClaw 控制面板
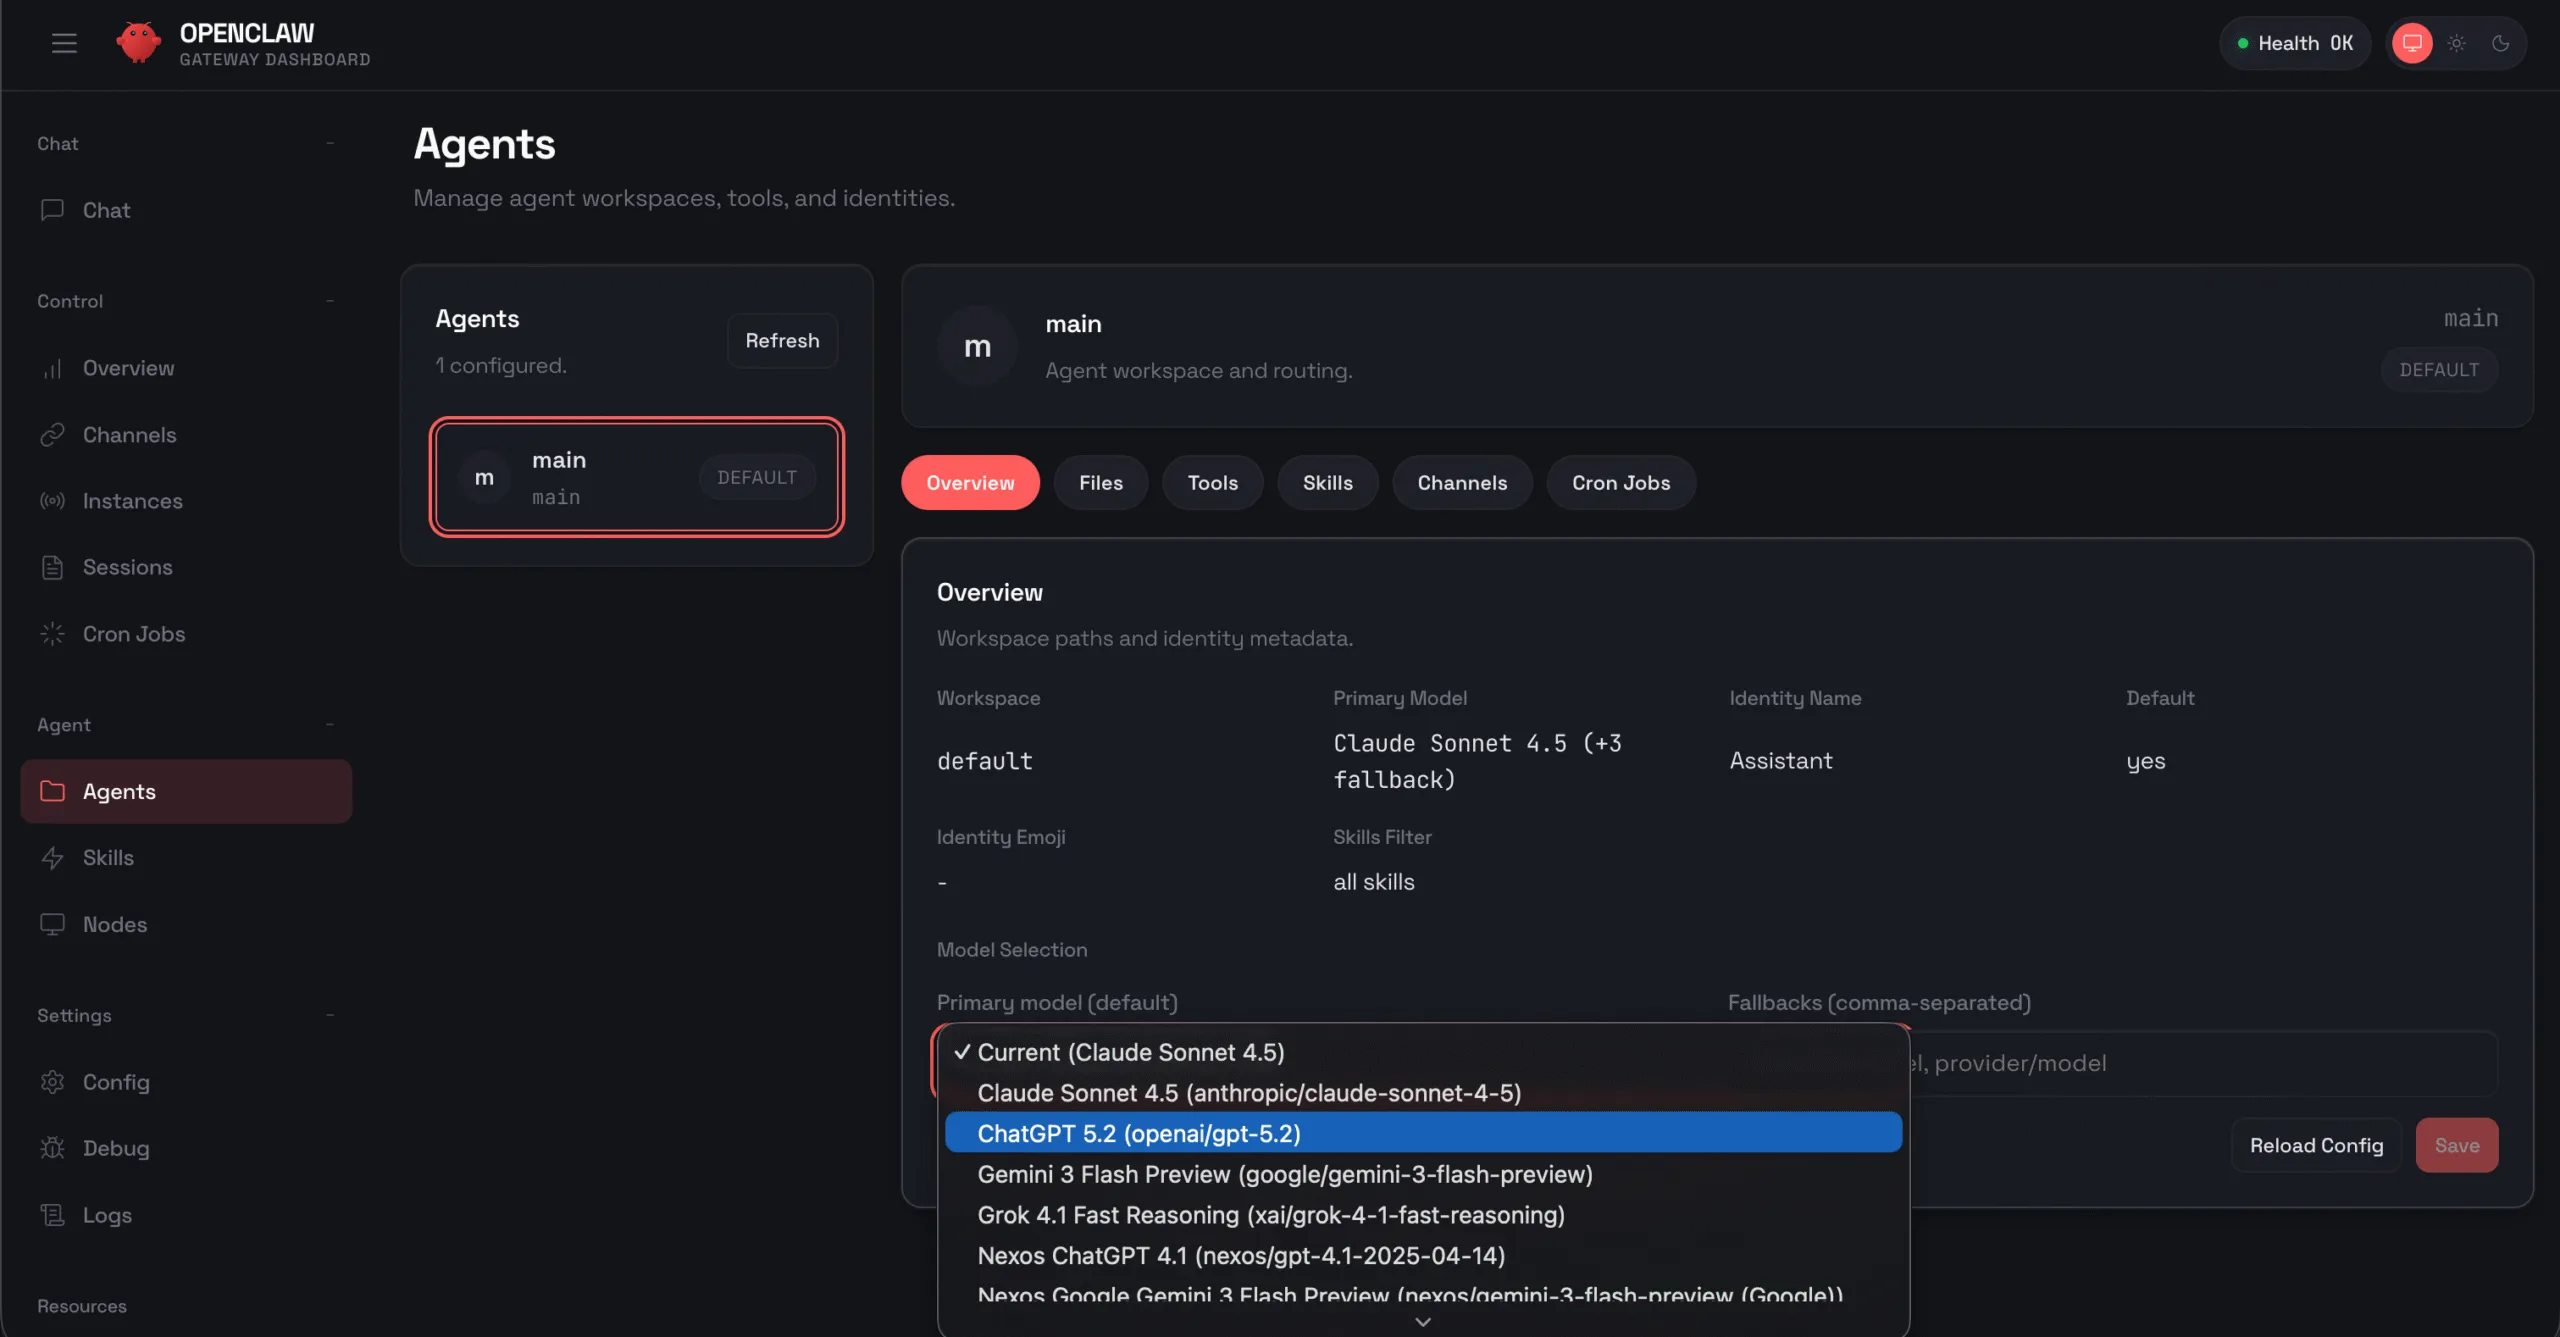
- 进入 Agents 页面
- 在模型选择下拉菜单中,选择你偏好的 AI 模型
完成这些步骤后,你的 OpenClaw 实例将连接到 Hostinger AI Router,所有 AI 模型使用量都将从你的 AI 额度余额中扣除。
在 OpenClaw 中选择 AI 模型
OpenClaw 部署并连接到 Hostinger AI Router 后,你可以选择代理要使用的 AI 模型。
- 在 OpenClaw 控制面板中,打开你的代理配置并找到模型选择下拉菜单。在那里,你可以选择任何支持的模型,例如 Claude、ChatGPT、Gemini 或其他可用的服务商。
- 模型选择界面允许你随时切换模型,而无需重新部署 OpenClaw。这样你可以根据实际使用场景,轻松平衡成本、性能和响应质量。
不同模型消耗 AI 额度的速率不同。
你可以在 Hostinger 控制面板 → AI Router → Models 中查看每个模型完整且最新的价格信息。
额度使用量如何计算
通过 Hostinger AI Router 提供的每个 AI 模型都有各自的额度消耗标准,具体取决于模型规模、推理能力和响应质量等因素。越高级的模型消耗额度越快,而轻量级模型在处理简单任务时则更具成本效益。你的额度余额由所有连接到 Hostinger AI Router 的 OpenClaw 代理共享,也可用于其他使用 AI 额度的 Hostinger AI 产品。
每次请求前都会检查你的余额,因此你的 AI 额度永远不会低于零。如果余额不足以支付某次请求,该请求将被拒绝,而不会产生扣费。
支持的模型及价格
下表列出了在 OpenClaw 中使用 AI 额度时可用的部分 AI 模型及其额度消耗。
| 模型 | 输入成本(每 100 万 token) | 输出成本(每 100 万 token) | 缓存创建(每 100 万 token) | 缓存输入(每 100 万 token) |
|---|---|---|---|---|
| Claude Sonnet 4.5 | 3.3 额度 | 16.5 额度 | 4.125 额度 | 0.33 额度 |
| Claude Opus 4.6 | 5.5 额度 | 27.5 额度 | 6.75 额度 | 0.55 额度 |
| Claude Opus 4 | 15 额度 | 75 额度 | 18.75 额度 | 1.5 额度 |
| Gemini 3 Flash | 0.5 额度 | 3 额度 | 不适用 | 0.05 额度 |
| GPT-4.1 | 2.2 额度 | 8.8 额度 | 不适用 | 0.55 额度 |
| Grok 4 | 3 额度 | 15 额度 | 不适用 | 0.75 额度 |
选择合适的模型
通过 Hostinger AI Router 提供的每个模型都适合不同的任务。以下是帮助你选择模型的概要说明:
- Claude Sonnet 4.5 是一款均衡型模型,具备出色的推理能力,写作清晰,并支持编程。它在商务任务、结构化输出(如 JSON 或报告)、详细讲解以及日常 AI 助手方面表现出色。对于大多数需要兼顾质量和效率的应用来说,这是一个可靠的默认选择。
- Claude Opus 4.6 是一款专为复杂分析和高级问题解决而打造的高端模型。它在深度研究任务、多步骤逻辑、长上下文理解和高精度输出方面表现优异。当准确性和高级推理至关重要时,请选择此模型。
- Claude Opus 4 针对高强度推理和复杂 AI 工作流进行了优化。它非常适合企业级任务、高级 AI 代理、深度分析工作以及多层次问题解决。对于需要最强能力的严苛使用场景,此模型是理想之选。
- Gemini 3 Flash 是一款快速、轻量的模型,针对大批量任务和快速响应任务进行了优化。它在摘要生成、简单问答、内容生成以及可扩展的聊天机器人应用方面表现出色。当速度和响应能力是首要考虑因素时,请选择此模型。
- GPT-4.1 是一款多用途模型,适合结构化工作流、编程、自动化和工具集成。它在商业环境中能够提供稳定的结果,在需要稳定、可预测输出的系统中表现良好。对于生产就绪的应用来说,此模型是一个强劲的选择。
- Grok 4 是一款专为生动互动和创意生成而设计的对话模型。它在头脑风暴、社交内容创作、休闲聊天体验以及个性化助手方面表现出色。如果你的应用注重创意和用户互动,请选择此模型。
各项费用的含义
- 输入 token 是你发送给模型的文本,例如提示词、指令或对话历史。
- 输出 token 是模型响应时生成的文本。
- 缓存创建是指在存储可复用的上下文以降低未来成本时产生的费用。
- 缓存输入定价适用于复用之前缓存的上下文,而非重新处理的情况。
- 越高级的模型通常消耗的额度越多,尤其是输出 token;而 Gemini 3 Flash 等轻量级模型在处理简单或大批量任务时更具成本效益。
Hostinger AI Router 免去了手动配置 API 的繁琐,让你无需任何配置即可使用多种 AI 模型,从而简化了 OpenClaw 的使用体验。在部署 OpenClaw 时添加 AI 额度,你就可以立即开始使用 AI,并直接在 OpenClaw 控制面板中管理一切。